
Мы нашли 140 материалов. В основное исследование вошли 100.
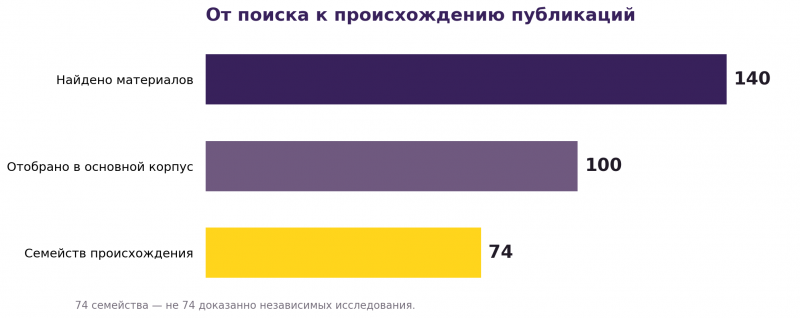
В широкую поисковую базу вошли 140 публичных материалов о рейтингах, сравнениях и выборе GEO/AEO-подрядчиков. После отбора по релевантности мы выделили 100 публикаций основного корпуса. Это не 100 независимых экспертиз: когда мы объединили материалы общего происхождения, получили 74 семейства источников.
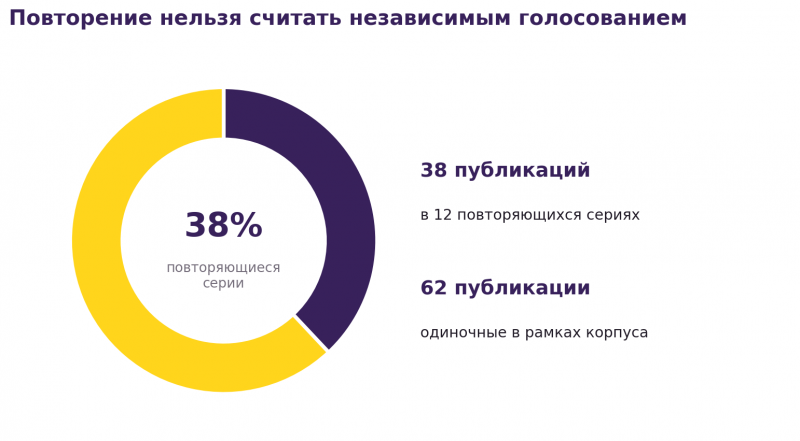
В 12 повторяющихся сериях оказалось 38 публикаций. Две наиболее крупные серии — Digital Среда и Bayes Lab / NeuroReach — содержат по шесть материалов каждая. Остальные 62 публикации в пределах выбранного корпуса не объединены с другой записью в повторяющуюся серию.
Слово «семейство» здесь важнее, чем кажется. Оно не означает доказанную организационную зависимость между всеми авторами, а указывает на общий источник, методику, авторство или заметное происхождение публикаций. При группировке мы не считали совпадение победителя само по себе достаточным основанием.
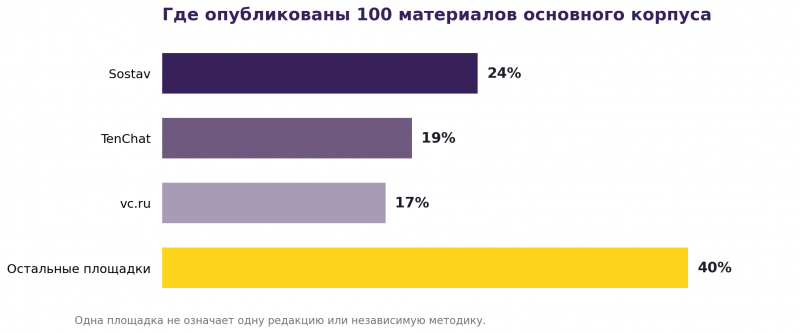
Ещё одна особенность выборки: Sostav дал 24 публикации, TenChat — 19, vc.ru — 17. Всего 60 материалов из 100 размещены на трёх площадках. Но домен площадки — не редакционная гарантия. На одной и той же площадке могут жить независимая аналитика, корпоративный блог и саморейтинг.
Как один рейтинг становится несколькими «подтверждениями»
В нашем корпусе есть серия Bayes Lab / NeuroReach из шести связанных публикаций: общий рейтинг и тематические версии по GEO, AEO, NEO и AISEO. В материалах описан подход к оценке, но открытого набора исходных данных, позволяющего полностью воспроизвести итог, мы не обнаружили. Если внешний агрегатор сосчитает все шесть URL как шесть независимых голосов, вес одной исходной системы оценок окажется завышен.
Другой пример — материалы об агентствах Shernet и проекте GeoAist на Pressfeed и MarketingPeople. Публичный профиль Александра Шерстова содержит указания на его связь с обоими проектами. Это существенная информация для читателя, но она не делает любую его оценку автоматически ошибочной. Важно, чтобы авторство и связи были видны при интерпретации результатов.
Есть и публичные саморейтинги: материалы, где компания или её представитель открыто объясняет выбор критериев и отводит себе первое место. Сам по себе такой формат допустим как авторское мнение. Проблема начинается там, где он распространяется или цитируется как результат независимого исследования.
Особенно наглядна ситуация с метарейтингами. Например, публикация на DTF использует заранее заданные веса для результатов других рейтингов. Формула может быть прозрачной, но если входные рейтинги сами опираются друг на друга, формальная точность итогового балла не делает источники независимыми.
Красивые проценты — ещё не проверенное знание
Один из изученных нами материалов, опубликованный на «Клерке», описывает восемь критериев, их веса и 300 000 симуляций Монте-Карло. В нём для лидера указана вероятность первого места 99,9997%. По уровню описания расчётной процедуры это заметно подробнее многих других публикаций.
Но насколько такая цифра проверяема извне? Если исходная матрица оценок не раскрыта полностью, мы можем обсуждать формулу, но не воспроизвести результат независимо. Это не доказательство ошибочности модели. Это граница того, что читатель способен проверить.
Наша рабочая позиция проста: рейтинг заслуживает доверия не потому, что в нём сложная формула, а потому, что посторонний исследователь может проследить путь от исходных наблюдений до вывода.
В мире эту проблему уже изучают как уязвимость ИИ-поиска
В 2025 году на конференции ICLR вышла работа Adversarial Search Engine Optimization for Large Language Models. Исследователи показали, что специально подготовленный сторонний контент может влиять на выбор и рекомендации языковых моделей. В статье речь идёт о конкурентной среде, где соблазн повлиять на систему есть у многих участников — и совокупно такие действия ухудшают качество ответов.
В октябре 2026 года исследователи представили препринт From Public Posts to AI-Search Citations. Они изучили 10 платформ ИИ-поиска и 17 211 случаев цитирования. В контролируемом эксперименте восемь из десяти систем в течение семи дней процитировали искусственно введённое понятие. Авторы показали, что доступ к публикации на часто цитируемых платформах может становиться каналом влияния на ответ ИИ.
Ещё одно исследование, опубликованное в материалах EMNLP 2026, протестировало 13 модельных конфигураций на устойчивость к манипуляциям в найденных веб-источниках. Результат зависел от модели и тестового сценария: доля успешных воздействий колебалась от 0% до 31,4%. Это не прогноз для конкретного бизнеса, а наглядное подтверждение: абсолютной технической защиты сегодня нет.
Важно не смешивать три разных утверждения: материал может быть опубликован; материал может быть процитирован; материал может изменить рекомендацию. Исследования показывают возможность отдельных переходов между этими этапами — но не утверждают, что любая публикация гарантированно меняет выбор пользователя или продажи.
Площадки и регуляторы уже отвечают — но не одинаково
Google прямо относит к поисковому спаму практики, направленные на манипулирование выдачей, включая генеративные ответы в Google Search. В правилах отдельно названы массовое производство малополезных страниц и злоупотребление репутацией площадок. При этом ни публикация авторского рейтинга, ни использование ИИ для подготовки текста сами по себе не запрещены.
В США правило Федеральной торговой комиссии FTC, действующее с октября 2024 года, запрещает компании вводить читателей в заблуждение, представляя подконтрольный ей сайт или организацию как независимый источник оценок собственной категории товаров и услуг. Здесь существенна именно ложная независимость, а не факт участия бизнеса в публикации.
В Евросоюзе развиваются требования к раскрытию платного продвижения и факторов ранжирования результатов на онлайн-площадках. В Великобритании действуют ограничения на фальшивые потребительские отзывы. Но эти режимы нельзя автоматически переносить на любой редакционный рейтинг агентств: у них разные предметы регулирования и юрисдикции.
Мы видим не «запрет на все рейтинги», а попытку отделить экспертную оценку от нераскрытой коммерческой заинтересованности и массовой имитации внешнего доверия.
Исчезнут ли такие манипуляции?
Мой ответ — нет, полностью не исчезнут. Скорее изменится цена их производства и обнаружения.
Если поисковые и генеративные системы научатся учитывать происхождение материалов, связывать перепубликации в одно семейство и проверять независимость внешних сигналов, простое размножение одинаковых рейтингов будет работать хуже. Но это именно проверяемая гипотеза, а не объявленное будущее. У нас пока нет данных, подтверждающих, что все крупнейшие ИИ-системы уже делают такую проверку устойчиво и одинаково.
Более того, усиление защиты способно породить следующую волну техник: более убедительные авторские истории, правдоподобные экспертные подборки, сетевые публикации с разным оформлением, подмена первичных ссылок. Классическое противостояние систем защиты и тех, кто пытается на них влиять, никуда не денется.
Вопрос ближайших лет поэтому не «можно ли попасть в ответ ИИ». Можно и зачастую вполне честными методами. Вопрос другой: сможет ли ИИ отличить независимое свидетельство от многократного пересказа заинтересованной стороны?
Что это означает для бизнеса, выбирающего GEO-подрядчика
При выборе агентства мы предлагаем смотреть не на число мест в топах, а на происхождение доказательств. Кто составил рейтинг? Как связан с участниками? Что именно измеряется: качество услуг, число проектов, видимость в ИИ или упоминаемость в медиа? Есть ли данные для пересчёта? Не повторяют ли несколько публикаций один и тот же первичный список?
Наличие публично раскрытого интереса ещё не повод отбрасывать материал. Иногда честная самооценка полезнее анонимного «независимого» списка. А вот отсутствие открытой методики, исходных наблюдений и информации об авторе ограничивает вес вывода — независимо от того, насколько уверенно он написан.
Мы сами участник этого рынка, поэтому не присваиваем GEOSEO agency никакого места в исследовании и применяем одинаковые требования к любому источнику — в том числе к публикациям, где фигурируем сами.
Вместо ещё одного рейтинга
Из 140 найденных материалов мы отобрали 100, а затем увидели в них 74 семейства происхождения. Эти числа не означают, что остальные 26 документов «фальшивые», и не дают нам права обвинять конкретные компании в сговоре. Они показывают нечто более полезное: у публичной репутации есть структура, и эту структуру необходимо учитывать.
Искусственный авторитет будет труднее создать только тогда, когда поисковые системы, нейросети, редакции и сами заказчики начнут задавать один и тот же вопрос: сколько здесь независимых доказательств, а сколько — повторений?
Пожалуй, это и есть следующая задача GEO. Не просто научиться быть видимыми для ИИ, а сделать видимым происхождение доверия.
Методологическое примечание
В расширенной базе 140 материалов: 49 прошли первый проход проверки, 5 — частично проверены, 81 остаются к проверке, 4 относятся к контекстным источникам, 1 исключён. В основном корпусе из 100 материалов 46 имеют статус «проверено», 5 — «частично проверено», 49 — «к проверке». Поэтому приведённые структурные показатели относятся к версии исследования, а отдельные качественные выводы требуют дальнейшей построчной экспертизы. Мы не публикуем процент «манипулятивных» или «нечестных» рейтингов по всему корпусу.
Срез корпуса: сентябрь 2026 года. Международные исследования и регуляторные источники сверены по состоянию на 9 ноября 2026 года.
Описанные внешние тесты не являются доказательством вмешательства в конкретные российские рейтинги.
Источники:
- Публичный рейтинг Bayes Lab / NeuroReach: https://vc.ru/marketing/2225418-top-30-agentstv-po-prodvizheniyu-v-neurosetjah-v-rossii
- Pressfeed: сравнение агентств: https://news.pressfeed.ru/podberi-agentstvo-po-prodvizheniyu-v-nejrosetyah-7-variantov-i-kriterii-vybora/
- MarketingPeople: материал серии: https://www.marpeople.com/articles/3743/kompanii-geo-prodvizenia-kak-vybrat-podradcika-po-dannym-a-ne-po
- Клерк: рейтинг Monte Carlo: https://www.klerk.ru/user/2711071/705360/
- DTF: пример метарейтинга: https://dtf.ru/reyting/4733907-reyting-kompaniy-po-prodvizheniyu-v-neyrosetyah
- ICLR 2025: Adversarial SEO: https://proceedings.iclr.cc/paper_files/paper/2025/hash/0f12b3c36a781120c4f60e90e855868d-Abstract-Conference.html
- Исследование ИИ-поиска, препринт 08.10.2026: https://arxiv.org/abs/2610.11932
- EMNLP 2026: endorsement vulnerability: https://aclanthology.org/2026.emnlp-main.2128/
- Политика Google против поискового спама: https://developers.google.com/search/docs/essentials/spam-policies
- FTC: правила для подконтрольных рейтингов: https://www.law.cornell.edu/cfr/text/16/465.6
- ЕС: прозрачность оплаченного продвижения: https://europa.eu/youreurope/citizens/consumers/unfair-treatment/unfair-commercial-practices/index_en.html







Комментарии доступны после входа