

Еще недавно ИИ в работе со звуком воспринимался в основном как технология для создания неестественной речи и простых аудиоэффектов. Сегодня возможности генеративных моделей значительно шире. Они умеют создавать полноценные музыкальные композиции с вокалом, озвучивать тексты и книги, генерировать звуковые эффекты, изменять голос в готовой записи и поддерживать практически полноценный разговор в реальном времени.
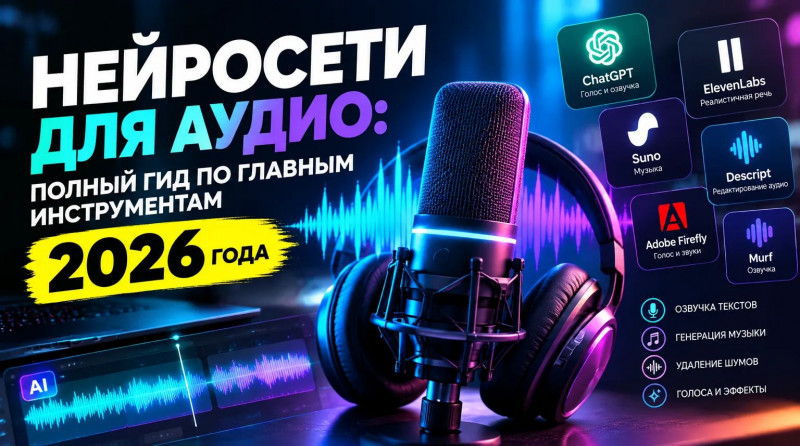
Разберем восемь ИИ-инструментов, которые позволяют работать с голосом, музыкой и различными видами звука:
- — голосовой режим для общения с ИИ
- — генерация естественной речи из текста
- — генерация звуковых эффектов по текстовому запросу
- — изменение голоса в готовой аудиозаписи
- — генерация музыки с возможностью управлять ее структурой
- — создание музыки и саунд-дизайна для профессиональных задач
- — открытая линейка моделей для генерации длинных аудиотреков
- — генерация песен и музыкальных композиций
Все представленные модели для генерации и обработки аудио собраны в агрегаторе . Платформа позволяет работать с современными ИИ-моделями без VPN и иностранных банковских карт. Новым пользователям доступны 100 приветственных токенов бесплатно.
1. Голосовые ассистенты
Что это. Голосовой режим ChatGPT от OpenAI создан прежде всего для естественного общения с ИИ, а не для получения готовых аудиотреков. В современных системах обработка голоса происходит гораздо сложнее классической последовательности «распознавание речи → текст → ответ → синтез». Модель учитывает темп разговора, паузы, интонацию и другие особенности человеческой речи.
Основные возможности:
- Разговор в реальном времени. Пользователь может перебить ассистента, попросить изменить темп или манеру речи, сделать голос тише или добавить эмоциональности.
- Несколько языков. Во время диалога можно использовать разные языки и при необходимости переключаться между ними.
- Разные голоса. Доступно несколько вариантов звучания, каждый из которых отличается характером и подачей.
- Доступность. Голосовой режим доступен бесплатно с определенными ограничениями, а дополнительные возможности зависят от выбранного тарифа.
Кому подойдет. Инструмент будет полезен для разговорной практики, изучения иностранных языков, подготовки к собеседованиям, голосовых заметок и обычного общения с ИИ. Для производства профессиональной дикторской записи он не является основным решением.
Минусы. Возможности экспорта полученного аудио и его коммерческого применения ограничены. Кроме того, на отдельных менее распространенных языках качество синтеза может быть менее стабильным.
2. Синтез речи и изменение голоса: ElevenLabs
ElevenLabs предлагает сразу несколько решений для работы с голосом. С их помощью можно создавать речь из текста, генерировать звуковые эффекты и преобразовывать уже записанный голос.
Что это. Инструмент преобразует письменный текст в речь, стараясь воспроизводить естественные паузы, интонации и эмоциональные особенности человеческого голоса.
Что доступно:
- более 70 языков, включая русский;
- библиотека готовых голосов;
- Voice Design для создания нового голоса по текстовому описанию;
- клонирование голоса в режимах Instant и Professional;
- управление эмоциональной подачей с помощью текстовых инструкций в Eleven v3;
- API с низкой задержкой для чат-ботов, игровых персонажей и голосовых агентов.
Цены. Бесплатный тариф включает около 10 000 кредитов в месяц. Стоимость платных планов начинается примерно с $6 в месяц, а коммерческая лицензия доступна в платных вариантах.
Кому подойдет. Сервис подходит для создания аудиокниг, озвучки роликов и рекламы, подкастов, онлайн-курсов и голосовых интерфейсов.
Что это. Сервис превращает текстовое описание в звуковой эффект. Пользователь задает сцену или источник звука, а модель создает соответствующий аудиофрагмент.
Возможности:
- создание природных, бытовых, игровых и кинематографических эффектов;
- генерация коротких фрагментов продолжительностью от долей секунды примерно до 22–30 секунд в зависимости от версии;
- настройка степени влияния текстового запроса на результат;
- автоматический выбор продолжительности;
- создание нескольких вариантов одного эффекта.
Цены. В среднем одна генерация обходится примерно в 200 кредитов. При работе через API стоимость составляет около $0,12 за минуту аудио.
Кому подойдет. Инструмент может пригодиться саунд-дизайнерам, разработчикам игр, монтажерам, создателям рекламы, видео и подкастов.
Что это. Voice Changer позволяет заменить голос в существующей записи, сохранив при этом особенности оригинального исполнения — темп, интонацию, эмоциональную подачу и манеру речи.
Основные функции:
- преобразование речи и вокала в один из тысяч доступных голосов;
- поддержка более 70 языков;
- замена черновой записи на другой голос без необходимости полностью перезаписывать материал;
- возможность интеграции через API и быстрой обработки аудио.
Кому подойдет. Решение интересно разработчикам игр, авторам подкастов, создателям контента и тем, кому требуется изменить голос в готовой записи.
Ограничение. Качество результата во многом определяется исходным материалом. Сильный фоновый шум или низкое качество записи могут негативно повлиять на итог.
3. Генерация музыки
Что это. Suno превращает текстовое описание или готовую лирику в полноценную песню. Сервис способен самостоятельно сформировать вокальную партию, аранжировку и структуру композиции. Актуальная версия — v5.5, представленная в марте 2026 года.
Что умеет:
- создавать реалистичный вокал в различных музыкальных жанрах;
- использовать функцию Voices для генерации песен с голосом пользователя после необходимой проверки;
- обучать Custom Models на собственной музыкальной коллекции;
- учитывать индивидуальные предпочтения через My Taste;
- управлять стилем и структурой композиции с помощью текстовых инструкций;
- разделять готовую композицию на отдельные стемы для последующей обработки.
Цены. Доступен бесплатный тариф с ограничениями. Платные планы начинаются примерно от $10 в месяц и предоставляют возможности коммерческого использования.
Кому подойдет. Suno подойдет музыкантам, авторам контента и всем, кто хочет быстро превратить музыкальную идею в готовую композицию.
Что это. MiniMax Music создает музыкальные композиции на основе описания стиля и текста песни. При необходимости можно отказаться от вокала и получить инструментальный трек.
Возможности версии 2.6:
- генерация инструментальных композиций по текстовому описанию;
- автоматическое создание текста песни, если пользователь не добавляет собственную лирику.
Преимущества, сохранившиеся от версии 2.5:
- естественный вокал с дыханием и динамикой;
- более 14 структурных тегов для управления развитием композиции;
- возможность задавать BPM и тональность через промпт;
- широкий выбор инструментов, в том числе традиционных и оркестровых;
- создание треков продолжительностью до 6 минут;
- до 3500 символов текста и до 2000 символов описания стиля.
Языки. Наиболее предсказуемый результат обычно получается при использовании английского и китайского. Русский язык поддерживается, однако качество вокала может быть менее стабильным.
Кому подойдет. MiniMax Music представляет интерес для разработчиков и создателей контента, которым важен программный доступ и возможность детально управлять характеристиками композиции. API доступен через Replicate, WaveSpeed и другие платформы.
Что это. Stable Audio 2.5 от Stability AI ориентирован преимущественно на профессиональные команды, агентства и бренды. Модель появилась в сентябре 2025 года.
Возможности:
- создание структурированных композиций продолжительностью до трех минут;
- стереозвук с частотой 48 кГц для профессионального производства;
- управление жанром, настроением и развитием композиции при помощи обычного текста;
- Audio-to-Audio и инпейнтинг для работы с уже существующим аудио;
- использование лицензированных обучающих данных и защитных механизмов;
- адаптация модели под фирменную аудиобиблиотеку компании.
Кому подойдет. Stable Audio 2.5 рассчитана на проекты в сфере саунд-брендинга, рекламы, приложений, цифровых сервисов и корпоративного производства контента.
Что это. Stable Audio 3 — следующее поколение моделей Stability AI, представленное в мае 2026 года. Важной особенностью линейки стали открытые веса и несколько вариантов модели: Small, Medium и Large.
Что умеет:
- создавать стереоаудио продолжительностью до 6 минут 20 секунд с частотой 44,1 кГц;
- генерировать музыку и различные звуковые эффекты;
- редактировать отдельные части записи с помощью инпейнтинга;
- продолжать уже существующие аудиотреки;
- задавать переменную длительность генерации;
- создавать длинные фрагменты на производительном GPU;
- запускаться локально, причем версия Small подходит даже для MacBook Pro без отдельной видеокарты.
Кому подойдет. Stable Audio 3 будет интересна разработчикам, исследователям и студиям, которым необходим локальный запуск, контроль над данными и возможность интегрировать модель в собственные решения.
Какую нейросеть выбрать для конкретной задачи
- Для общения с ИИ, языковой практики и репетиций — ChatGPT Голос.
- Для аудиокниг, курсов, рекламы и профессиональной озвучки — ElevenLabs Озвучка.
- Для создания эффектов в видео и играх — ElevenLabs Sound Effects.
- Для замены голоса с сохранением исходной подачи — ElevenLabs Voice Changer.
- Для быстрого создания полноценной песни — Suno.
- Для более точного контроля структуры, BPM и тональности через API — MiniMax Music 2.6.
- Для корпоративного саунд-дизайна и проектов, где особенно важны вопросы лицензирования, — Stable Audio 2.5.
- Для локальной генерации и экспериментов с открытыми моделями — Stable Audio 3.
Главные тенденции генеративного аудио
- ИИ переходит от коротких эффектов к полноценным композициям. Современные модели способны создавать треки продолжительностью в несколько минут и самостоятельно формировать их структуру.
- Персонализация становится важнее. Клонирование голоса позволяет использовать индивидуальную манеру звучания в новых аудиоматериалах.
- Открытые модели получают больше возможностей. Stable Audio 3 демонстрирует, что мощные аудиомодели можно запускать локально и интегрировать в собственные проекты.
- Голос превращается в интерфейс. Низколатентные API и голосовые режимы делают взаимодействие с ИИ все более похожим на обычный разговор.
- Лицензирование становится одним из ключевых факторов. При выборе инструмента бизнесу важно учитывать не только качество генерации, но и права на использование результата.
Генеративный звук перестал быть исключительно экспериментальной технологией. Сейчас это полноценный рабочий инструмент для музыкантов, разработчиков, маркетологов, монтажеров и других создателей контента.
Нейросети для аудио: генерация, обработка, расшифровка и создание звуков
Современные ИИ-сервисы позволяют существенно упростить практически любой этап работы со звуком. С их помощью можно создавать музыку и эффекты, преобразовывать текст в речь, распознавать аудиозаписи, переводить голос, удалять шумы и улучшать уже готовые дорожки.
Такие инструменты подходят не только профессионалам музыкальной и видеосферы. Ими могут пользоваться блогеры, авторы подкастов, маркетологи, разработчики и обычные пользователи. Многие сервисы работают прямо в браузере и не требуют установки сложного программного обеспечения.
Что умеют нейросети для аудио
Функциональность зависит от конкретной модели, но современные ИИ-инструменты способны:
- генерировать речь по текстовому запросу;
- создавать музыку и звуковые эффекты;
- превращать текст в аудиофайл;
- распознавать человеческую речь;
- переводить аудио в текст;
- переводить голос на другие языки;
- удалять фоновый шум;
- повышать качество записи;
- создавать аудиосопровождение для видео;
- редактировать готовые аудиодорожки.
Поэтому под термином «нейросеть для аудио» сегодня объединяется сразу несколько категорий технологий.
Бесплатные нейросети для аудио
Чтобы начать работать с ИИ для звука, необязательно сразу оформлять платную подписку. Многие сервисы предоставляют бесплатные тарифы, которых достаточно для тестирования и решения простых задач.
Бесплатные версии могут ограничивать количество генераций, длительность записи или доступ к отдельным функциям. Тем не менее их возможностей часто хватает для озвучки короткого ролика, расшифровки интервью или базовой обработки записи.
Нейросеть для генерации аудио
Генеративные аудиомодели создают новые звуковые материалы на основе текстовой команды или другого исходного контента.
В зависимости от сервиса можно получить:
- музыкальную композицию;
- голосовую дорожку;
- атмосферный фон;
- звуковой эффект;
- короткий аудиофрагмент;
- музыку для видео, игры или подкаста.
Особенно полезны такие решения авторам, которым необходимо регулярно создавать большое количество оригинального аудиоконтента.
Нейросеть для создания аудио
ИИ можно использовать для автоматического производства самых разных звуковых материалов — от рекламной озвучки до музыкального сопровождения презентаций, курсов и подкастов.
Главное преимущество таких решений — скорость. Вместо поиска диктора или организации студийной записи пользователь может подготовить текст и получить готовую аудиодорожку за несколько минут.
Современные модели также позволяют управлять тембром, интонацией, скоростью и эмоциональной подачей речи.
Нейросеть для аудио из текста
Технология Text-to-Speech, или TTS, преобразует написанный текст в звучащую речь.
Она применяется для:
- озвучивания статей;
- создания видеороликов;
- производства аудиокниг;
- рекламных материалов;
- онлайн-курсов;
- презентаций;
- голосовых сообщений.
Как правило, пользователю достаточно вставить текст, выбрать голос и настроить необходимые параметры. После обработки сервис сформирует готовую аудиозапись.
Разместите тендер бесплатно
Наша система самостоятельно подберет исполнителей для задач, связанных с разработкой сайтов и приложений, SEO, контекстной рекламой, маркетингом, SMM и PR.
проведено за восемь лет работы нашего сайта.
Нейросеть для расшифровки аудио
ИИ умеет выполнять и обратную задачу — превращать готовую аудиозапись в текст.
Это особенно удобно при работе с интервью, лекциями, встречами, телефонными разговорами и диктофонными записями.
Современные модели способны распознавать нескольких участников разговора, автоматически расставлять знаки препинания и приводить результат к более удобному для чтения виду.
Нейросеть для расшифровки аудио в текст
Автоматическая транскрибация значительно сокращает время обработки записей. Пользователю не приходится самостоятельно переслушивать каждый фрагмент и переносить речь в документ.
Достаточно загрузить аудиофайл, запустить распознавание и проверить получившийся текст. После этого документ можно отредактировать вручную.
На итоговую точность влияют качество записи, наличие фоновых шумов, язык и особенности речи участников.
Нейросеть для перевода аудио
Перевод аудиозаписи с помощью ИИ обычно включает несколько последовательных этапов: распознавание исходной речи, перевод текста и последующий синтез нового голоса.
Таким образом, исходный материал можно преобразовать в текст, перевести на другой язык и получить новую аудиодорожку.
Технология востребована при локализации видео, переводе интервью, создании образовательных материалов и работе с международной аудиторией.
Некоторые современные сервисы дополнительно стараются сохранить темп, интонацию и характер исходной подачи.
Нейросеть для звука
Понятие «нейросеть для звука» включает широкий спектр решений, предназначенных для создания, анализа и обработки аудиоматериалов.
ИИ может работать с человеческой речью, музыкой, шумами и отдельными эффектами. Поэтому такие технологии применяются при создании видео, игр, рекламы, подкастов и музыкальных проектов.
Нейросеть для генерации звуков
Отдельный класс инструментов предназначен для создания звуковых эффектов по текстовому описанию.
Пользователь может описать дождь, шаги, шум города, движение автомобиля, закрытие двери или природный пейзаж — и модель создаст соответствующий аудиофрагмент.
Это позволяет быстрее находить нужное звучание и уменьшает зависимость от традиционных фонотек.
Бесплатная нейросеть для звуков
Если звуковые эффекты нужны нерегулярно, можно воспользоваться бесплатным тарифом подходящего сервиса. Как правило, он ограничивает количество генераций или длительность создаваемых файлов.
Для небольших видеороликов, презентаций и первых экспериментов таких возможностей может быть достаточно.
Нейросеть для создания звуков
Генеративные модели позволяют создавать звук непосредственно под конкретную сцену.
Вместо долгого поиска подходящего файла в библиотеке пользователь описывает нужный эффект и получает несколько вариантов на выбор.
ИИ также можно использовать для создания фоновых шумов и атмосферных дорожек, которые делают сцену более реалистичной.
Нейросеть для звука видео
Во время видеомонтажа часто требуется обработать голос, удалить шум, добавить музыку или усилить отдельные эффекты. ИИ позволяет автоматизировать значительную часть этой работы.
Модели анализируют аудиодорожку и самостоятельно выполняют ряд операций, которые раньше требовали ручной настройки в специализированном редакторе.
Особенно востребованы автоматическое шумоподавление, повышение разборчивости речи и нормализация громкости.
Нейросеть для генерации звука для видео
Такие инструменты позволяют создавать аудиосопровождение с учетом содержания конкретного видеоролика.
С их помощью можно генерировать:
- звуки окружающей среды;
- шаги;
- движение различных объектов;
- атмосферные шумы;
- дополнительные эффекты;
- музыку;
- голосовое сопровождение.
Это особенно полезно видеомейкерам, блогерам, разработчикам игр и другим создателям цифрового контента.
Нейросеть для улучшения звука
Не всегда требуется генерировать новую аудиодорожку. Во многих случаях достаточно улучшить уже существующую запись.
ИИ может:
- уменьшить фоновый шум;
- убрать отдельные помехи;
- сделать голос более разборчивым;
- улучшить качество записи с микрофона;
- выровнять громкость;
- повысить четкость речи.
Такие инструменты особенно полезны для записей со смартфона, домашних подкастов и материалов, созданных в помещениях с плохой акустикой.
Нейросеть для обработки звука
ИИ также способен автоматизировать большое количество операций, которые раньше выполнялись вручную в аудиоредакторах.
Система может определить речь и посторонние шумы, разделить разные компоненты записи и применить необходимые эффекты обработки. Во многих сервисах для этого достаточно загрузить файл и выбрать нужный режим.
В результате даже пользователи без глубоких знаний в звукорежиссуре могут получить приемлемый результат и существенно сократить время обработки.
Как выбрать нейросеть для работы с аудио
Выбирать ИИ-инструмент лучше исходя из конкретной задачи.
Если необходимо превратить текст в речь, понадобится TTS-сервис. Для обработки интервью, лекций и совещаний подойдет инструмент транскрибации. Для видеомонтажа и разработки игр пригодятся генераторы звуковых эффектов. А если нужно восстановить качество существующей записи, стоит обратить внимание на функции шумоподавления и улучшения голоса.
Перед выбором сервиса стоит проверить:
- поддерживает ли он русский язык;
- какие функции доступны бесплатно;
- есть ли ограничения по размеру и длительности файлов;
- насколько естественно звучит результат;
- какие форматы экспорта доступны;
- можно ли работать с голосами;
- сколько времени занимает обработка;
- разрешено ли использовать результат в коммерческих проектах.
Заключение
ИИ постепенно меняет привычный подход к работе с аудио. Современные нейросети способны не только генерировать музыку, голос и эффекты, но и распознавать речь, переводить записи, очищать звук от шума и улучшать уже готовые материалы.
Бесплатные тарифы позволяют протестировать основные возможности без покупки профессионального ПО, а генеративные модели дают возможность создавать новые аудиоматериалы буквально из текстового описания.
В результате нейросети становятся универсальным инструментом практически для всего аудиопроцесса — от создания первой идеи и генерации звука до его обработки, перевода и подготовки финальной версии для публикации.








Нет комментариев
Комментарии доступны после входа