
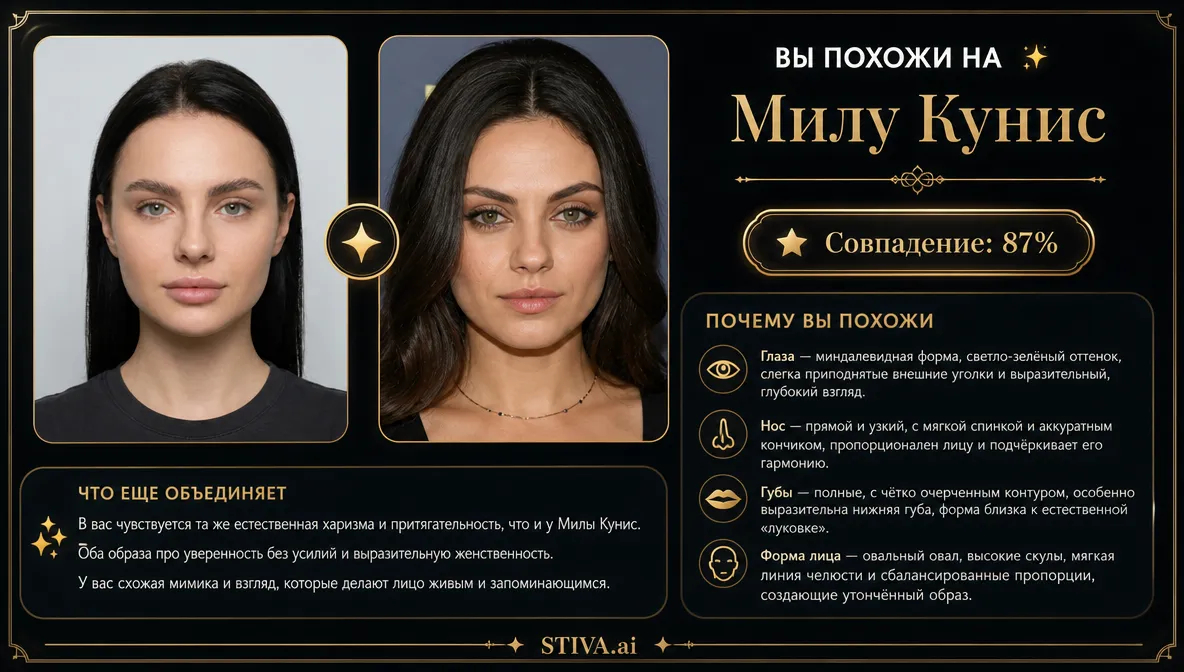
В лентах всё чаще попадаются одинаковые на вид карточки: слева ваше фото, справа — известный актёр или музыкант, между ними знак сравнения, внизу строка «Совпадение: 83%» и разбор четырёх черт лица. Формат разошёлся по соцсетям именно потому, что повторяется без усилий: одно селфи, один скопированный запрос, полторы минуты ожидания.
Сделать такую карточку самостоятельно можно за две минуты. В этом тексте — три шага до результата, полный промпт с объяснением каждой его части, пять ошибок, из-за которых нейросеть выдаёт ерунду, и короткая справка о том, как модель вообще решает, что вы похожи на знаменитость.
Три шага до карточки со звёздным двойником
Шаг первый — инструмент. Нужна модель, которая умеет принимать картинку на вход и возвращать картинку с текстом. В для этого подходит : она не перерисовывает загруженное лицо и нормально держит длинные инструкции на русском. Почему не другие варианты — разбираем в отдельном разделе ниже.
Шаг второй — снимок. Загружаете одно своё фото: анфас, при дневном свете, без фильтров и без очков. Подробные требования — в следующем разделе, от них зависит примерно половина итогового совпадения.
Шаг третий — запрос. Копируете промпт ниже, вставляете в поле запроса и запускаете генерацию. Через 30–90 секунд получаете готовую карточку: имя знаменитости, процент сходства и пояснение, какие именно черты лица совпали.
Никаких настроек, пресетов и подписок настраивать не нужно. Если результат не понравился — меняете фото или пару строк в промпте и запускаете заново.
Промпт целиком и что означает каждая его часть
Копируйте блок ниже полностью.
Изучи лицо человека на загруженной фотографии и определи известную публичную персону, с которой наблюдается наибольшее визуальное сходство. Анализируй только видимые черты: форму и пропорции лица, глаза, брови, нос, губы, скулы, подбородок и общую структуру лица; не используй стереотипы и не делай выводов о характере, здоровье или других качествах, которые нельзя определить по фото.
Создай стильную премиальную карточку полностью на русском языке: тёмный фон, золотые акценты, тонкая рамка и элегантные декоративные элементы. Сверху размести исходное фото пользователя слева и портрет выбранной знаменитости справа, между ними — аккуратный символ сравнения.
Добавь заголовок «ВЫ ПОХОЖИ НА ✨», имя знаменитости, блок «Совпадение: XX%», а также раздел «ПОЧЕМУ ВЫ ПОХОЖИ» с 4 конкретными особенностями лица и индивидуальным объяснением каждой. Ниже добавь раздел «ЧТО ЕЩЁ ОБЪЕДИНЯЕТ» с коротким позитивным текстом на 2–3 предложения о стиле или общей визуальной атмосфере. Внизу размести небольшую подпись «STIVA.ai».
Не искажай и не редактируй фотографию пользователя — используй её без изменений. Все описания должны основываться именно на загруженном фото, без шаблонных комплиментов. Результат должен выглядеть современно, премиально, легко и развлекательно — как вирусный ИИ-тест из социальных сетей.
Запрос разделён на четыре части, и каждая делает свою работу.
Первая часть — задание на анализ. Здесь модель получает перечень признаков, по которым нужно сравнивать: геометрия лица, глаза, брови, нос, губы, скулы, подбородок. И здесь же стоит запрет, который важнее, чем кажется: не использовать стереотипы и не делать выводов о характере, здоровье и прочих качествах, которые по фотографии не определяются. Без этой строки нейросеть начинает «додумывать» человека по внешности — и карточка из развлечения превращается в бестактность.
Вторая часть — визуальное оформление. Тёмный фон, золото, тонкая рамка, два портрета и знак сравнения между ними. Это то, из-за чего результат выглядит как готовый контент, а не как черновик.
Третья часть — структура текста на карточке. Заголовок, имя, процент, четыре совпавшие черты с пояснениями, короткий блок про общую атмосферу и подпись. Чем конкретнее перечислены элементы, тем меньше шансов, что модель что-то забудет или разместит как попало.
Четвёртая часть — защита исходника. Прямое указание не редактировать и не искажать фотографию пользователя. Без него часть моделей по привычке «улучшает» лицо: сглаживает кожу, подправляет овал, меняет причёску. В тесте на сходство это ломает весь смысл — сравнивать нужно то лицо, которое вы загрузили.
Отдельно про формулировку «известную публичную персону». Она задаёт ширину поиска, и её удобно сужать. Попросите «актёра кино», «музыканта», «спортсмена» или «российского артиста» — и модель начнёт искать внутри этой группы. Узкая выборка почти всегда даёт более неожиданные и более смешные совпадения, чем поиск по всем знаменитостям сразу.
Почему нейросеть иногда выдаёт не то: пять ошибок и как их исправить
Ошибка первая: селфи с вытянутой руки. Широкоугольная камера на близкой дистанции растягивает нос и сжимает уши — пропорции уезжают, и модель сравнивает уже искажённое лицо. Исправление: отойдите на расстояние вытянутой руки плюс ещё немного или попросите кого-то снять вас с двух-трёх метров.
Ошибка вторая: фильтры и бьютификация. Они убирают именно то, что нужно для анализа: текстуру, форму скул, контур губ. Исправление: исходник без обработки, пусть даже он кажется вам менее выгодным.
Ошибка третья: боковой или жёлтый свет. Тени от лампы сбоку съедают половину признаков, а тёплый свет меняет оттенок кожи. Исправление: встаньте лицом к окну днём — это лучший бесплатный источник света для такого теста.
Ошибка четвёртая: широкая улыбка или сложный ракурс. Сильная улыбка меняет форму щёк и подбородка, профиль скрывает половину лица. Исправление: анфас или лёгкий полуоборот, спокойное выражение или полуулыбка.
Ошибка пятая: ожидание единственно верного ответа. Модель анализирует снимок, а не человека, поэтому на разных фотографиях она зацепится за разные черты и назовёт разных звёзд. Исправление: воспринимайте результат как один из возможных вариантов и прогоните два-три снимка — из них сложится куда более полная картина.
Как модель решает, что вы похожи
Никакой базы фотографий знаменитостей у нейросети нет, и «поиск по картинке» здесь не при чём. Механика другая: модель раскладывает ваше лицо на признаки, описывает их словами, а затем по этому описанию вспоминает публичных людей с похожим набором черт.
В описание попадает форма лица и соотношение его частей, посадка и разрез глаз, излом бровей, ширина спинки и форма кончика носа, объём губ, выраженность скул, линия подбородка и челюсти. Плюс общее впечатление — типаж, который сложно сформулировать, но легко узнать.
При этом характер, голос, манеры, происхождение и родство в анализ не попадают в принципе: по фотографии их не определить. Отсюда типичная ситуация — вам называют человека, на которого вы «совсем не похожи», но стоит присмотреться, и выясняется, что совпали разрез глаз и линия подбородка. Три-четыре сильных совпадения дают более точный ответ, чем общее ощущение сходства.
Что означает процент совпадения
Цифра вроде «Совпадение: 83%» выглядит как результат измерения, но измерением не является. Модель не сравнивает ваше лицо с эталоном и не вычисляет математическую близость признаков — она подбирает правдоподобную оценку, которая согласуется с её же текстовым объяснением.
По смыслу это степень уверенности модели в выбранном сравнении. Условно: около девяноста процентов — совпало почти всё, около шестидесяти — похожи отдельные черты при общем сходстве типажа.
Практических следствия два. Первое: читать нужно не проценты, а пояснения — в них видно, за какие именно черты зацепилась модель, и с этим уже можно спорить. Второе: повторный запуск на том же фото может дать и 74%, и 88% с одной и той же знаменитостью. Это не сбой, так устроена генерация.
И главное: никакой экспертизой эта цифра не является. Ни родства, ни происхождения она не подтверждает и юридической силы не имеет.
Какую модель выбрать, если GPT Image 2 не подошла
Для теста годится любая мультимодальная модель, принимающая изображение на вход. Отличаются они двумя вещами: насколько бережно обращаются с вашим лицом и насколько аккуратно собирают итоговую карточку с текстом.
— рабочий вариант по умолчанию. Точно передаёт исходные черты, понимает длинные инструкции на русском, рисует аккуратный дизайн. Минус один: генерация чуть дольше, чем у быстрых моделей.
GPT Image 2.5 — берите, если исходное фото неидеальное: сложный ракурс, нехватка света, лёгкий смаз. Эта версия устойчивее к таким условиям, но требовательнее к формулировкам запроса.
Gemini (Nano Banana) — самый быстрый вариант и лучший для работы с несколькими изображениями сразу: удобно, если делаете парную карточку на двоих. Обратная сторона — модель чаще «приукрашивает» внешность пользователя.
Специализированные face-swap-сервисы — результат мгновенный и без промпта, но звёзд выбирают из шаблонной базы и не объясняют свой выбор. Для развлечения достаточно, для осмысленного сравнения — нет.
Все четыре варианта доступны в одном окне : переключаться между моделями можно без повторной загрузки фото и без переписывания запроса. Если первый результат вышел спорным, проще сменить модель и повторить, чем начинать всё заново.
Что ещё можно сделать с этим тестом
Собрать рейтинг своих двойников. Прогоните три-пять разных снимков: спокойный портрет, фото с улыбкой, кадр в другом образе, снимок при другом освещении. На каждом модель сделает акцент на разных чертах, и знаменитости получатся разные.
Пройти тест вдвоём. Загрузите два фото и попросите определить, на какую известную пару вы похожи вместе. Промпт почти не меняется: достаточно указать, что на снимках два человека, и попросить одну карточку с двумя колонками — в каждой фото, имя, процент и три совпавшие черты с пояснениями.
Сменить стиль оформления. Вместо тёмного фона с золотом попросите обложку глянцевого журнала девяностых, постер фильма, концертную афишу или неоновый киберпанк. Содержание то же, подача совсем другая.
Добавить блок-антипод. Впишите в конец промпта просьбу добавить раздел «НА КОГО ВЫ ТОЧНО НЕ ПОХОЖИ» с одной знаменитостью и причиной. Обычно это самая обсуждаемая часть карточки.
Сравнить результаты с друзьями. Один и тот же промпт у разных людей даёт совершенно разные пары знаменитостей — именно поэтому формат так легко расходится по чатам.
Короткий словарь, если термины новые
Промпт — текстовая инструкция для нейросети. В нашем случае это тот самый блок, который вы копируете в поле запроса: чем конкретнее он написан, тем предсказуемее результат.
Мультимодальная модель — модель, которая работает не только с текстом, но и с изображениями: принимает картинку на вход и умеет возвращать картинку с текстом. Для теста на сходство нужна именно такая.
Генерация — процесс создания результата после запуска запроса. Здесь занимает от тридцати секунд до полутора минут.
Агрегатор нейросетей — сервис, где разные модели собраны в одном интерфейсе. Не нужно регистрироваться в каждом отдельно и разбираться в разных тарифах: выбираете модель из списка и работаете в одном окне.
Частые вопросы
Нейросеть найдёт моего настоящего двойника?
Нет. Она подбирает известную персону с близким типажом по видимым чертам лица и объясняет свой выбор. Поиск генетического или «настоящего» двойника — задача другого рода, и по одной фотографии она не решается.
Почему при повторном запуске на том же фото ответ другой?
Генерация не детерминирована: модель каждый раз собирает ответ заново. Могут поменяться и выбранная знаменитость, и процент. Если расхождение сильное, стоит проверить качество снимка — скорее всего, часть черт на нём читается плохо.
Сколько фото нужно загрузить для точного результата?
Одного достаточно, чтобы получить карточку. Два-три разных снимка дают более полную картину: модель увидит ваше лицо в разных условиях и назовёт больше вариантов сходства.
Можно загрузить фото другого человека?
Только с его согласия. Тест с чужим снимком без спроса — уже не развлечение. И не стоит загружать групповые кадры: модель не поймёт, чьё лицо анализировать.
Насколько безопасно отправлять своё фото в нейросеть?
Для теста достаточно обычного селфи — документы, адреса, номерные знаки и посторонние люди в кадре не нужны. Условия обработки изображений стоит посмотреть в пользовательском соглашении сервиса; в агрегаторах вроде запрос уходит в выбранную модель.
Это бесплатно?
Зависит от сервиса: часть площадок даёт стартовые генерации бесплатно, дальше — по тарифу. Стоимость одной карточки обычно невелика и сопоставима с ценой чашки кофе.
Итог
Тест «на кого похож» — самый быстрый способ увидеть, как нейросеть читает ваше лицо: одно фото, один промпт, полторы минуты ожидания.
Чтобы результат не разочаровал, достаточно трёх вещей. Взять модель, которая не перерисовывает исходник, — . Загрузить снимок анфас при дневном свете, без фильтров и очков. И не относиться к проценту как к измерению: смысл не в цифре, а в пояснении, какие черты совпали.
Откройте , выберите GPT Image 2, загрузите своё лучшее селфи и вставьте промпт из этой статьи. А потом прогоните ещё пару снимков — и посмотрите, кого модель найдёт в каждом образе. Часто именно второй и третий результат оказываются интереснее первого.


Нет комментариев
Комментарии доступны после входа